Параллельно с deeproute попробовали научить нейросеть разводить платы так, как это делают люди. Все за один день, 11 октября, на арендованных H100 и H200 в Runpod.
Данные: 52 233 платы KiCad с GitHub, GitLab, Codeberg и открытых бенчмарков, 6.56 млн шагов разводки. Каждую трассу человека режем на шаги «направление, длина, слой или переход» и учим модель угадывать следующий шаг. Платы, похожие на тестовые, из выборки выкинули, а Rabbit в обучение вообще не попадал.
Что попробовали:
- CNN по картинке 64×64 вокруг конца трассы: следующий шаг угадывает в 72% случаев
- ViT по картинке в трех масштабах: 72.7%
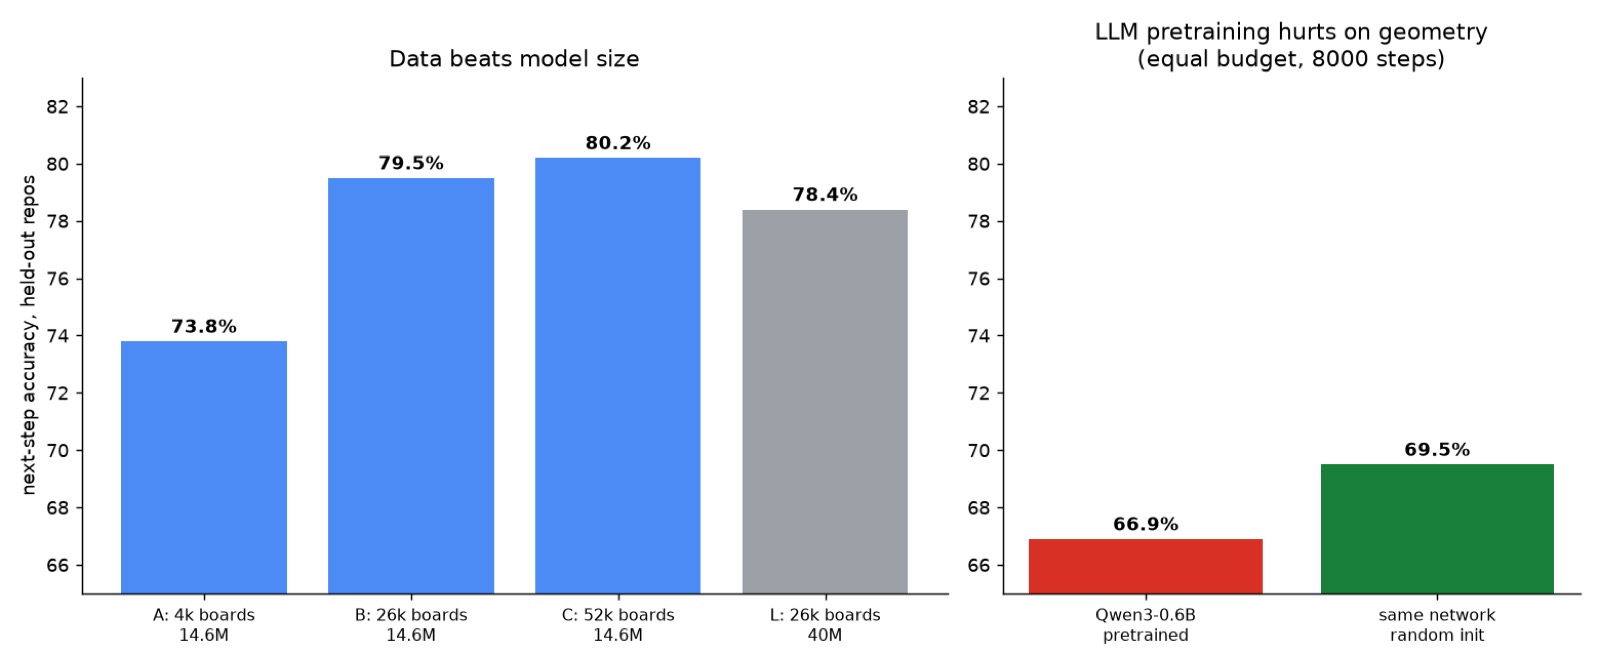
- RouteTok, трансформер не по пикселям, а по объектам платы (площадки, дорожки, отверстия), 14.6M параметров: 73.8% на 4 тысячах плат, 79.5% на 26 тысячах, 80.2% на 52 тысячах
- та же модель на 40M параметров: 78.4%, хуже маленькой
- Qwen3-0.6B как основа: с предобученными весами 66.9%, со случайными 69.5%. Знание текста геометрии только мешает
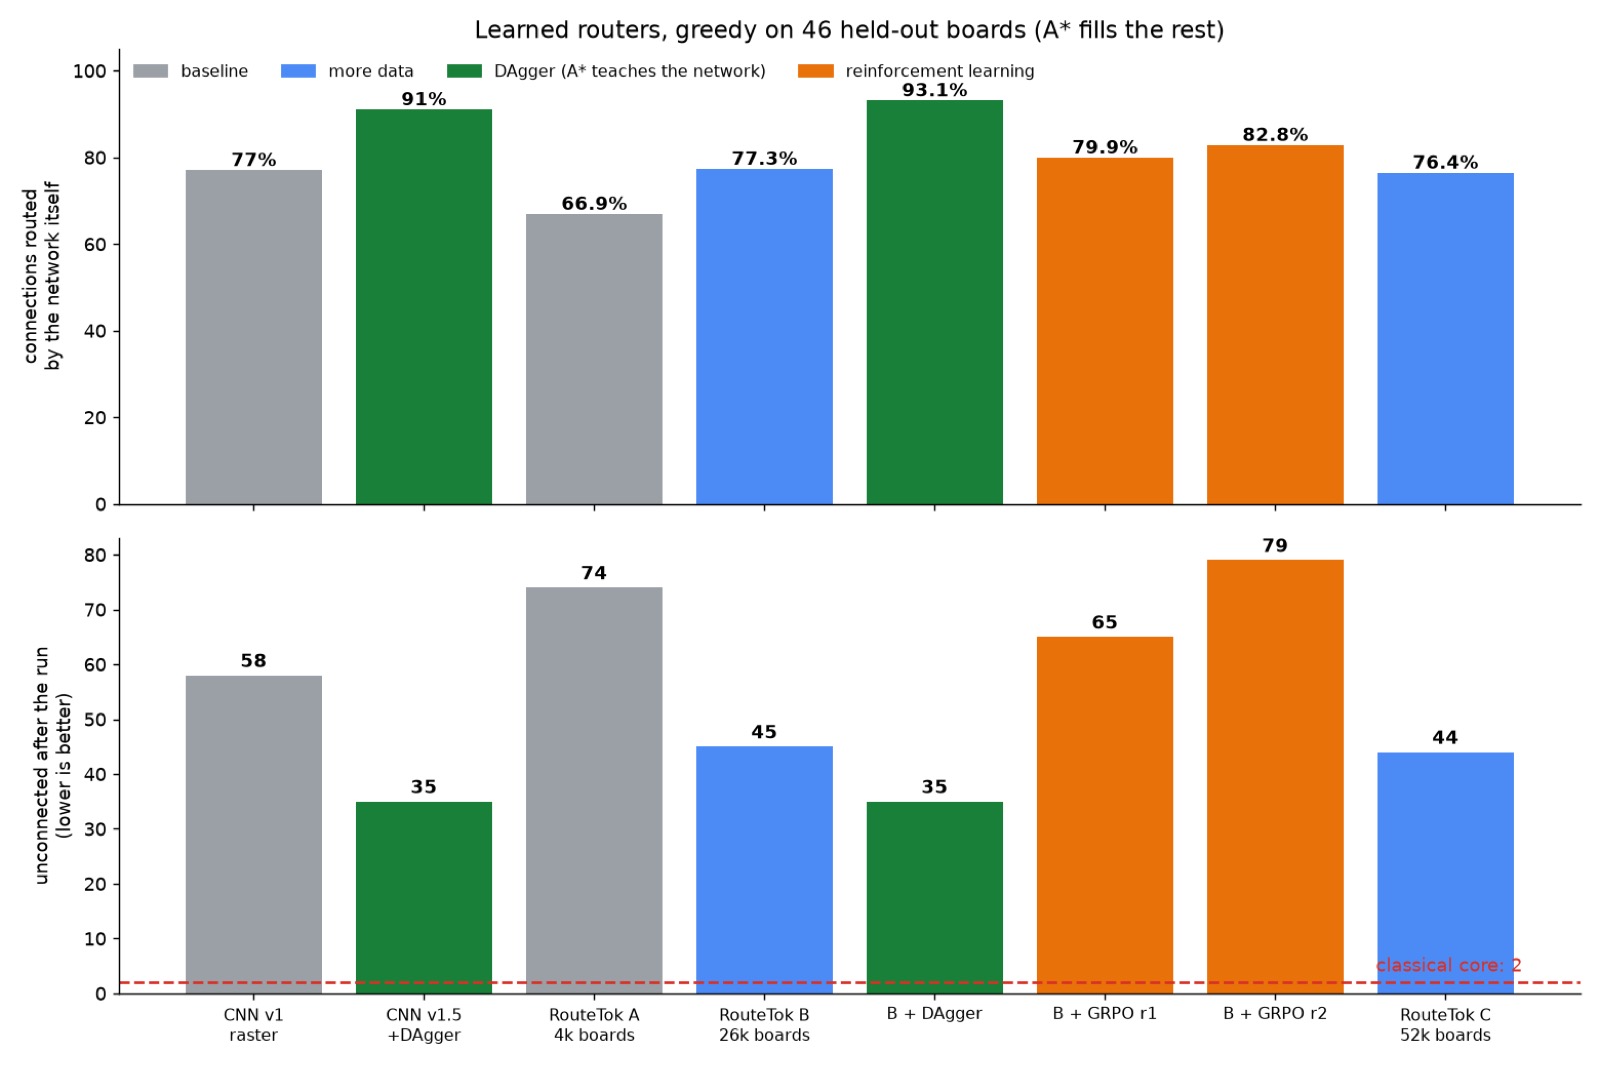
- DAgger: модель сама ведет трассу, а классический A* на каждом шаге подсказывает, как было бы правильно. Это лучшее, что сработало: доля соединений, которые нейросеть разводит сама, выросла с 77% до 93%
- обучение с подкреплением GRPO: модель разводила больше соединений сама, но занимала место, и плата в целом разводилась хуже. Классический обман награды
- LLM, которая пишет координаты текстом: в 45 раз больше токенов, около 2% законченных трасс, бросили сразу
Главные выводы: решают данные, а не размер модели. Точность угадывания шага почти ничего не говорит о том, разведет ли модель плату. И честно: лучшая сеть оставляет 35 неразведенных связей на 46 тестовых платах, классический алгоритм 2. Поэтому все рекорды deeproute ставит классическое ядро, а нейросети пока остаются исследовательской веткой.
Цена всего этого по счету Runpod: $115.76, из них $103.69 за GPU, примерно 23-24 GPU-часа (H100 около 17 часов, H200 около 6). Одна модель на 14.6M учится примерно час на H100 и стоит пару долларов. Датасеты на диске: 64 ГБ сырых плат и около 50 ГБ подготовленных токенов.